Passer au contenu principal
PERFORMANCE
DE BACKEND SPRING
Les techniques que tout
dev devrait connaître
Florian Beaufumé
• Architecte logiciel
et développeur senior
• Expert Java/Spring/backend
• Freelance depuis 15+ ans
• https://beaufume.fr/articles/
• @fbeaufume
Florian Beaufumé
• Identifier
• L'anecdote strcat
• Logs
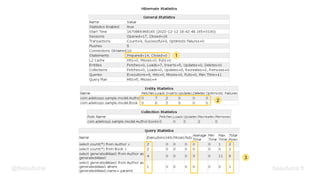
• Métriques Hibernate
• Traquer une requête SQL
• Optimiser
• Persistance : lectures, insertions, mises à jour
• Pool de connexion à la BD
• Transactions
• Cache
• Virtual threads
• Tests
• Mesurer
• Gatling
Sommaire
@fbeaufume beaufume.fr
IDENTIFIER
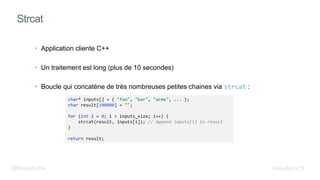
• Application cliente C++
• Un traitement est long (plus de 10 secondes)
• Boucle qui concatène de très nombreuses petites chaines via strcat :
Strcat
@fbeaufume
char* inputs[] = { "foo", "bar", "acme", ... };
char result[100000] = "";
for (int i = 0; i < inputs_size; i++) {
strcat(result, inputs[i]); // Append inputs[i] to result
}
return result;
beaufume.fr
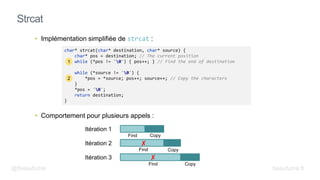
• Implémentation simplifiée de strcat :
• Comportement pour plusieurs appels :
Strcat
char* strcat(char* destination, char* source) {
char* pos = destination; // The current position
while (*pos != '0') { pos++; } // Find the end of destination
while (*source != '0') {
*pos = *source; pos++; source++; // Copy the characters
}
*pos = '0';
return destination;
}
Itération 1
Itération 2
Itération 3
Find
Find
Find
Copy
Copy
Copy
1
2
✘
✘
@fbeaufume beaufume.fr
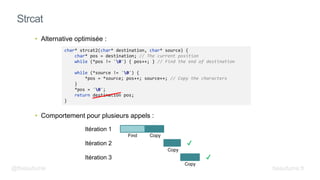
• Alternative optimisée :
• Comportement pour plusieurs appels :
Strcat
char* strcat2(char* destination, char* source) {
char* pos = destination; // The current position
while (*pos != '0') { pos++; } // Find the end of destination
while (*source != '0') {
*pos = *source; pos++; source++; // Copy the characters
}
*pos = '0';
return destination pos;
}
Itération 1
Itération 2
Itération 3
Find Copy
Copy
Copy
@fbeaufume beaufume.fr
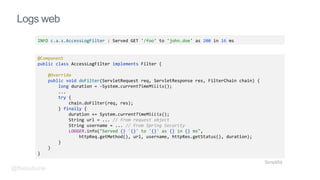
Logs web
INFO c.a.s.AccessLogFilter : Served GET '/foo' to 'john.doe' as 200 in 16 ms
@Component
public class AccessLogFilter implements Filter {
@Override
public void doFilter(ServletRequest req, ServletResponse res, FilterChain chain) {
long duration = -System.currentTimeMillis();
...
try {
chain.doFilter(req, res);
} finally {
duration += System.currentTimeMillis();
String url = ... // From request object
String username = ... // From Spring Security
LOGGER.info("Served {} '{}' to '{}' as {} in {} ms",
httpReq.getMethod(), url, username, httpRes.getStatus(), duration);
}
}
}
Simplifié
@fbeaufume
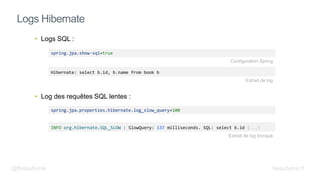
• Logs SQL :
• Log des requêtes SQL lentes :
Logs Hibernate
spring.jpa.show-sql=true
INFO org.hibernate.SQL_SLOW : SlowQuery: 137 milliseconds. SQL: select b.id (...)
spring.jpa.properties.hibernate.log_slow_query=100
Hibernate: select b.id, b.name from book b
Configuration Spring
Extrait de log
@fbeaufume
Extrait de log tronqué
beaufume.fr
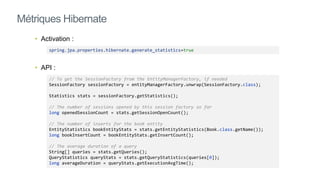
• Activation :
• API :
Métriques Hibernate
spring.jpa.properties.hibernate.generate_statistics=true
// To get the SessionFactory from the EntityManagerFactory, if needed
SessionFactory sessionFactory = entityManagerFactory.unwrap(SessionFactory.class);
Statistics stats = sessionFactory.getStatistics();
// The number of sessions opened by this session factory so far
long openedSessionCount = stats.getSessionOpenCount();
// The number of inserts for the book entity
EntityStatistics bookEntityStats = stats.getEntityStatistics(Book.class.getName());
long bookInsertCount = bookEntityStats.getInsertCount();
// The average duration of a query
String[] queries = stats.getQueries();
QueryStatistics queryStats = stats.getQueryStatistics(queries[0]);
long averageDuration = queryStats.getExecutionAvgTime();
1
2
3
beaufume.fr
@fbeaufume
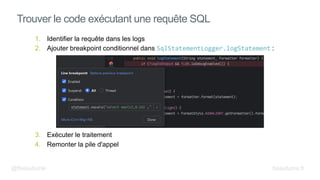
1. Identifier la requête dans les logs
2. Ajouter breakpoint conditionnel dans SqlStatementLogger.logStatement :
3. Exécuter le traitement
4. Remonter la pile d'appel
Trouver le code exécutant une requête SQL
@fbeaufume beaufume.fr
OPTIMISER
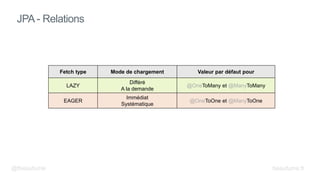
JPA - Relations
Fetch type Mode de chargement Valeur par défaut pour
LAZY
Différé
A la demande
@OneToMany et @ManyToMany
EAGER
Immédiat
Systématique
@OneToOne et @ManyToOne
@fbeaufume beaufume.fr
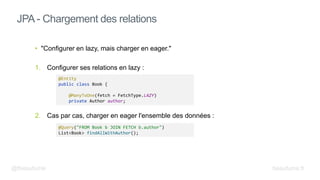
• "Configurer en lazy, mais charger en eager."
1. Configurer ses relations en lazy :
2. Cas par cas, charger en eager l'ensemble des données :
JPA - Chargement des relations
@Entity
public class Book {
@ManyToOne(fetch = FetchType.LAZY)
private Author author;
@Query("FROM Book b JOIN FETCH b.author")
List<Book> findAllWithAuthor();
@fbeaufume beaufume.fr
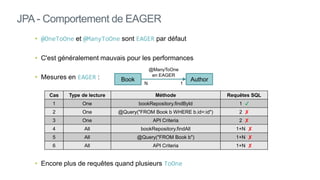
• @OneToOne et @ManyToOne sont EAGER par défaut
• C'est généralement mauvais pour les performances
• Mesures en EAGER :
• Encore plus de requêtes quand plusieurs ToOne
JPA - Comportement de EAGER
Book Author
N 1
@ManyToOne
en EAGER
Cas Type de lecture Méthode Requêtes SQL
1 One bookRepository.findById 1
2 One @Query("FROM Book b WHERE b.id=:id") 2 ✘
3 One API Criteria 2 ✘
4 All bookRepository.findAll 1+N ✘
5 All @Query("FROM Book b") 1+N ✘
6 All API Criteria 1+N ✘
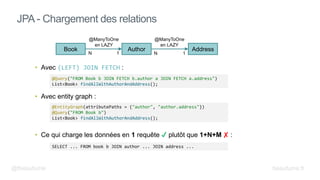
• Avec (LEFT) JOIN FETCH :
• Avec entity graph :
• Ce qui charge les données en 1 requête plutôt que 1+N+M ✘ :
JPA - Chargement des relations
@Query("FROM Book b JOIN FETCH b.author a JOIN FETCH a.address")
List<Book> findAllWithAuthorAndAddress();
@EntityGraph(attributePaths = {"author", "author.address"})
@Query("FROM Book b")
List<Book> findAllWithAuthorAndAddress();
Book Author
N 1
@ManyToOne
en LAZY
Address
1
N
@ManyToOne
en LAZY
SELECT ... FROM book b JOIN author ... JOIN address ...
@fbeaufume beaufume.fr
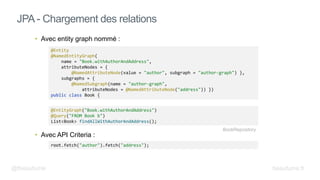
• Avec entity graph nommé :
• Avec API Criteria :
JPA - Chargement des relations
root.fetch("author").fetch("address");
@EntityGraph("Book.withAuthorAndAddress")
@Query("FROM Book b")
List<Book> findAllWithAuthorAndAddress();
@Entity
@NamedEntityGraph(
name = "Book.withAuthorAndAddress",
attributeNodes = {
@NamedAttributeNode(value = "author", subgraph = "author-graph") },
subgraphs = {
@NamedSubgraph(name = "author-graph",
attributeNodes = @NamedAttributeNode("address")) })
public class Book {
BookRepository
@fbeaufume beaufume.fr
• JOIN FETCH, entity graph, etc, fonctionnent aussi avec des ToMany
• Mais pour chaque ToMany les rows sont multipliés
• De plus pour plusieurs ToMany il faut un type Set
• Envisager une seule ToMany à la fois et laisser Hibernate fusionner
JPA - Relations ToMany
@fbeaufume beaufume.fr
JPA - Relations ToMany
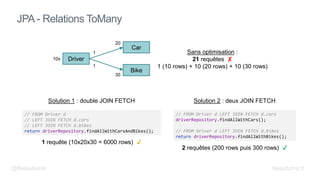
// FROM Driver d LEFT JOIN FETCH d.cars
driverRepository.findAllWithCars();
// FROM Driver d LEFT JOIN FETCH d.bikes
return driverRepository.findAllWithBikes();
Driver
Car
1
20
Bike
30
1
2 requêtes (200 rows puis 300 rows)
Sans optimisation :
21 requêtes ✘
1 (10 rows) + 10 (20 rows) + 10 (30 rows)
// FROM Driver d
// LEFT JOIN FETCH d.cars
// LEFT JOIN FETCH d.bikes
return driverRepository.findAllWithCarsAndBikes();
1 requête (10x20x30 = 6000 rows)
10x
Solution 1 : double JOIN FETCH Solution 2 : deux JOIN FETCH
@fbeaufume beaufume.fr
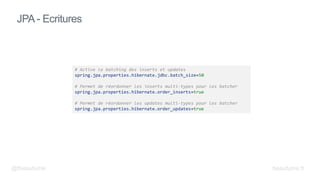
JPA - Ecritures
# Active le batching des inserts et updates
spring.jpa.properties.hibernate.jdbc.batch_size=50
# Permet de réordonner les inserts multi-types pour les batcher
spring.jpa.properties.hibernate.order_inserts=true
# Permet de réordonner les updates multi-types pour les batcher
spring.jpa.properties.hibernate.order_updates=true
@fbeaufume beaufume.fr
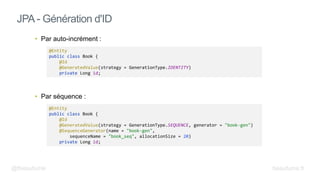
• Par auto-incrément :
• Par séquence :
JPA - Génération d'ID
@Entity
public class Book {
@Id
@GeneratedValue(strategy = GenerationType.SEQUENCE, generator = "book-gen")
@SequenceGenerator(name = "book-gen",
sequenceName = "book_seq", allocationSize = 20)
private Long id;
@Entity
public class Book {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Long id;
@fbeaufume beaufume.fr
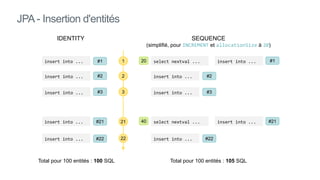
JPA - Insertion d'entités
insert into ...
IDENTITY SEQUENCE
(simplifié, pour INCREMENT et allocationSize à 20)
1
21
22
2
insert into ...
insert into ...
insert into ...
select nextval ... insert into ...
insert into ...
select nextval ... insert into ...
insert into ...
Total pour 100 entités : 100 SQL Total pour 100 entités : 105 SQL
3
insert into ... insert into ...
20
40
#1
#2
#3
#21
#22
#2
#3
#22
#1
#21
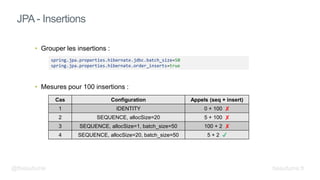
• Grouper les insertions :
• Mesures pour 100 insertions :
JPA - Insertions
spring.jpa.properties.hibernate.jdbc.batch_size=50
spring.jpa.properties.hibernate.order_inserts=true
Cas Configuration Appels (seq + insert)
1 IDENTITY 0 + 100 ✘
2 SEQUENCE, allocSize=20 5 + 100 ✘
3 SEQUENCE, allocSize=1, batch_size=50 100 + 2 ✘
4 SEQUENCE, allocSize=20, batch_size=50 5 + 2
@fbeaufume beaufume.fr
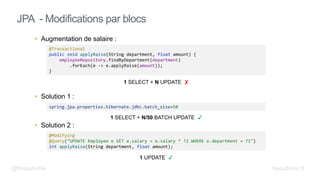
• Augmentation de salaire :
• Solution 1 :
• Solution 2 :
JPA - Modifications par blocs
@Modifying
@Query("UPDATE Employee e SET e.salary = e.salary * ?2 WHERE e.department = ?1")
int applyRaise(String department, float amount);
@Transactional
public void applyRaise(String department, float amount) {
employeeRepository.findByDepartment(department)
.forEach(e -> e.applyRaise(amount));
}
1 SELECT + N UPDATE ✘
1 UPDATE
@fbeaufume beaufume.fr
spring.jpa.properties.hibernate.jdbc.batch_size=50
1 SELECT + N/50 BATCH UPDATE
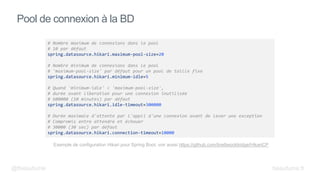
Pool de connexion à la BD
# Nombre maximum de connexions dans le pool
# 10 par défaut
spring.datasource.hikari.maximum-pool-size=20
# Nombre minimum de connexions dans le pool
# 'maximum-pool-size' par défaut pour un pool de taille fixe
spring.datasource.hikari.minimum-idle=5
# Quand 'minimum-idle' < 'maximum-pool-size',
# durée avant liberation pour une connexion inutilisée
# 600000 (10 minutes) par défaut
spring.datasource.hikari.idle-timeout=300000
# Durée maximale d'attente par l'appli d'une connexion avant de lever une exception
# Compromis entre attendre et échouer
# 30000 (30 sec) par défaut
spring.datasource.hikari.connection-timeout=10000
Exemple de configuration Hikari pour Spring Boot, voir aussi https://github.com/brettwooldridge/HikariCP
@fbeaufume beaufume.fr
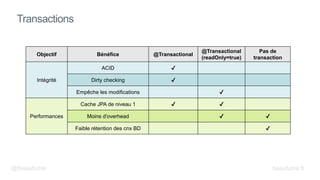
Transactions
Objectif Bénéfice @Transactional
@Transactional
(readOnly=true)
Pas de
transaction
Intégrité
ACID
Dirty checking
Empêche les modifications
Performances
Cache JPA de niveau 1
Moins d'overhead
Faible rétention des cnx BD
@fbeaufume beaufume.fr
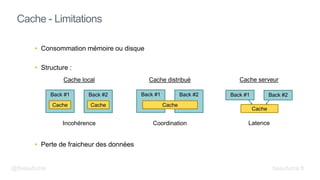
• Consommation mémoire ou disque
• Structure :
• Perte de fraicheur des données
Cache - Limitations
@fbeaufume
Back #1 Back #2 Back #1 Back #2 Back #1 Back #2
Cache
Cache
Cache Cache
Incohérence Coordination Latence
Cache local Cache distribué Cache serveur
beaufume.fr
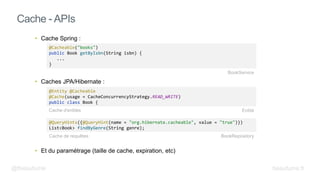
• Cache Spring :
• Caches JPA/Hibernate :
• Et du paramétrage (taille de cache, expiration, etc)
Cache - APIs
@Cacheable("books")
public Book getByIsbn(String isbn) {
...
}
@QueryHints({@QueryHint(name = "org.hibernate.cacheable", value = "true")})
List<Book> findByGenre(String genre);
BookService
@Entity @Cacheable
@Cache(usage = CacheConcurrencyStrategy.READ_WRITE)
public class Book {
BookRepository
Entité
Cache de requêtes
Cache d'entités
@fbeaufume beaufume.fr
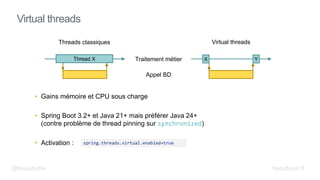
• Gains mémoire et CPU sous charge
• Spring Boot 3.2+ et Java 21+ mais préférer Java 24+
(contre problème de thread pinning sur synchronized)
• Activation :
Virtual threads
spring.threads.virtual.enabled=true
Traitement métier
Appel BD
Threads classiques Virtual threads
Thread X Y
X
@fbeaufume beaufume.fr
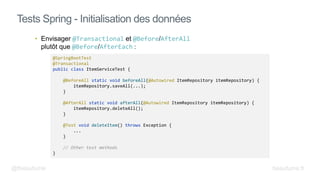
• Envisager @Transactional et @Before/AfterAll
plutôt que @Before/AfterEach :
Tests Spring - Initialisation des données
@SpringBootTest
@Transactional
public class ItemServiceTest {
@BeforeAll static void beforeAll(@Autowired ItemRepository itemRepository) {
itemRepository.saveAll(...);
}
@AfterAll static void afterAll(@Autowired ItemRepository itemRepository) {
itemRepository.deleteAll();
}
@Test void deleteItem() throws Exception {
...
}
// Other test methods
}
@fbeaufume beaufume.fr
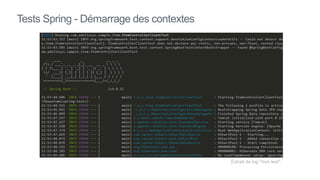
Tests Spring - Démarrage des contextes
Extrait de log "mvn test"
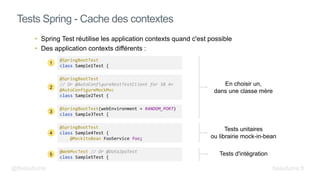
• Spring Test réutilise les application contexts quand c'est possible
• Des application contexts différents :
Tests Spring - Cache des contextes
@SpringBootTest
class Sample1Test {
@SpringBootTest(webEnvironment = RANDOM_PORT)
class Sample3Test {
@WebMvcTest // Or @DataJpaTest
class Sample5Test {
@SpringBootTest
class Sample4Test {
@MockitoBean FooService foo;
@SpringBootTest
// Or @AutoConfigureRestTestClient for SB 4+
@AutoConfigureMockMvc
class Sample2Test {
1
2
3
4
5 Tests d'intégration
Tests unitaires
ou librairie mock-in-bean
En choisir un,
dans une classe mère
@fbeaufume beaufume.fr
MESURER
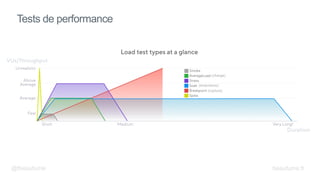
Tests de performance
(endurance)
(rupture)
(charge)
@fbeaufume beaufume.fr
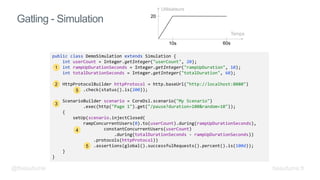
Gatling - Simulation
public class DemoSimulation extends Simulation {
int userCount = Integer.getInteger("userCount", 20);
int rampUpDurationSeconds = Integer.getInteger("rampUpDuration", 10);
int totalDurationSeconds = Integer.getInteger("totalDuration", 60);
HttpProtocolBuilder httpProtocol = http.baseUrl("http://localhost:8080")
.check(status().is(200));
ScenarioBuilder scenario = CoreDsl.scenario("My Scenario")
.exec(http("Page 1").get("/pause?duration=100&random=10"));
{
setUp(scenario.injectClosed(
rampConcurrentUsers(0).to(userCount).during(rampUpDurationSeconds),
constantConcurrentUsers(userCount)
.during(totalDurationSeconds - rampUpDurationSeconds))
.protocols(httpProtocol))
.assertions(global().successfulRequests().percent().is(100d));
}
}
Temps
Utilisateurs
10s 60s
20
1
2
3
4
5
5
@fbeaufume beaufume.fr
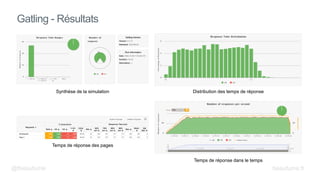
Gatling - Résultats
Synthèse de la simulation
Temps de réponse des pages
Temps de réponse dans le temps
Distribution des temps de réponse
@fbeaufume beaufume.fr
https://beaufume.fr/